Un vMotion sans VMware, et sans stockage partagé
 ludoEnglish version
ÉCRIT + IAÉcrit par Ludo à partir d'un premier jet de l'IA. · Certificat
Résumé technique (généré par IA)
- Le point de départ : chez VMware, vMotion déplaçait une VM allumée avec un stockage partagé, vCenter et des licences. Je croyais que c’était le prix de la migration à chaud.
- Ce que j’ai appris :
virsh migrate --live --copy-storage-allcopie le disque, puis la mémoire, pendant que la VM roule, sans stockage partagé.- Le terrain : deux Supermicro X11SRA. L’hôte d’arrivée doit garder 4 Go de libre en plus de la VM.
- Les chiffres : un worker k3s en 3 minutes, la VM Windows (128 Go) en 6, la console (100 Go) en 7.
- Transparence : construit en session avec Claude Code (Opus 5.5). Le mécanisme complet est dans le corollaire de Bob.
Je connaissais VMware et vMotion, et j’ai toujours eu pour notion que c’était une feature qui distinguait les hyperviseurs propriétaires de ceux disponibles librement. Depuis le tout début de mon labo, j’ai toujours visé à avoir une redondance qui me permettrait de faire basculer mes charges de travail d’un hôte à l’autre. Toutefois, le coût de VMware et l’effort que cela demandait pour maintenir de tels services dans mon labo m’ont rebuté plus d’une fois. Mais ces derniers mois, avec Claude Code, j’ai repoussé ces limites. Une première fois en déployant k3s sur mon infra et en y déployant mes petits services, comme la numérisation. Ensuite une deuxième fois, que je vous raconte ici, en facilitant la migration à chaud de mes machines virtuelles.
La semaine dernière, alors que je devais redémarrer mon serveur bob pour changer des paramètres dans son BIOS, je me suis laissé tenter une fois de plus de repousser les frontières du possible. J’ai demandé à Claude (Opus 5.5) s’il pouvait m’aider à rendre possible la migration à chaud de mes VM d’un hôte à l’autre, avec une interface facile d’usage.
Un peu de contexte : mes VM et les deux qui comptent le plus
Mes deux hyperviseurs, bob et stella, sont des Supermicro X11SRA avec des Xeon W-2135 et 48 Go de mémoire chacun. Ils hébergent six machines virtuelles en tout :
- coquille, la console. C’est sur celle-ci que roulent toutes mes sessions avec Claude, ainsi que toutes mes séances de terminal. Les jobs de nuit roulent aussi sur cette VM avec Qwen Code, dans leur propre session tmux. Depuis la séparation du bastion et de la console, c’est par cette machine que tout passe : les déploiements, les dépôts, le blogue, etc.
- win11, une machine virtuelle sous Windows 11 Pro. C’est par cette machine que passe Claude, avec Claude in Chrome, lorsqu’il doit passer par une interface web, pour aller chercher la saisie d’écran ci-bas par exemple.
- worker3 et worker5, deux noeuds k3s sans carte graphique, un par serveur.
- arcade1 et arcade2, les deux postes de jeu, qui restent cloués à leur hôte, qui contient leurs deux GPU pour jouer. Je les avais présentées dans mon article sur le GPU à la demande.
Avant, redémarrer bob impliquait de mettre coquille et win11 en veille, ce qui voulait dire que je perdais Claude Code le temps de la maintenance, et que Claude perdait son fureteur.
Ce que j’ai appris : pas besoin de stockage partagé
Dans les grappes d’hyperviseurs avec lesquelles j’avais travaillé dans le passé, la migration à chaud demandait d’exploiter une couche de stockage tierce, qui rendait la migration très rapide. Essentiellement, seule la mémoire devait être transférée d’un hôte à l’autre pour permettre le mouvement. Par contre, j’ai découvert depuis que le stockage partagé n’est pas obligatoire pour la migration à chaud. Qui plus est, c’est même possible avec des logiciels libres de faire la migration à chaud en copiant le stockage et la mémoire. Pour autant que je sache, cela demande une licence vCenter avec VMware.
Tout d’abord, j’ai suggéré à Claude qu’on migre le stockage des VM sur mon QNAP, pour justement avoir un stockage partagé. J’ai été bien content d’apprendre que ce n’était pas nécessaire. Claude m’a aussi fait remarquer que lorsque le stockage NFS était tombé dans le passé, ça avait verrouillé des hôtes au complet, ce qui en soi est pire que le problème que je cherchais à régler.
À la place, on a choisi de faire une copie intégrale à chaque mouvement que je déclenche. Tout tient dans une commande de libvirt :
virsh migrate --live --persistent --undefinesource --copy-storage-all \
  coquille qemu+ssh://stella/system
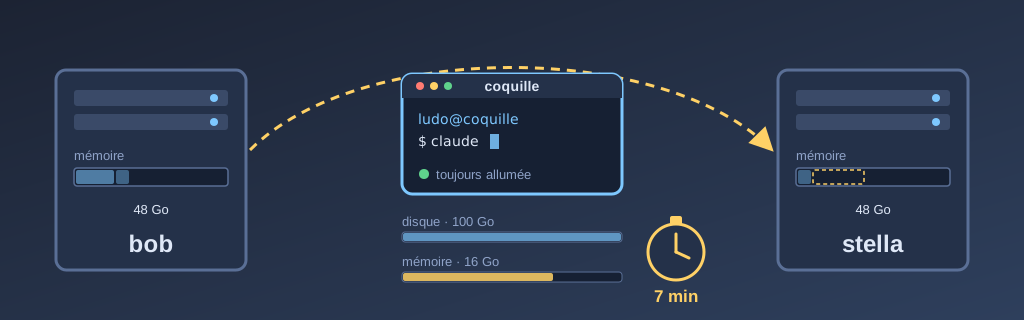
--copy-storage-all dit à QEMU de copier le disque vers l’autre serveur, tout en suivant les écritures qui arrivent pendant le transfert. --live copie la mémoire jusqu’à la bascule. La VM fige un court instant et repart de l’autre côté. Un détail qui me plaît : avec --persistent et --undefinesource, la définition de la VM part avec elle. Le serveur de départ oublie la VM et celui d’arrivée la garde. Comme la VM n’est jamais définie à deux endroits, elle ne peut jamais démarrer en double.
Autour de la commande, Claude Code a écrit un petit script, vm-move, qui vérifie avant de commencer que la VM n’a pas de carte graphique attachée, que l’hôte d’arrivée a assez de mémoire et que la VM n’y est pas déjà définie.
Le compromis, comparé à un vMotion avec stockage partagé, c’est le temps. On copie des dizaines de gigaoctets chaque fois, plutôt que quelques gigaoctets de mémoire. Pour le comment détaillé, la pré-copie de la mémoire, les refus de libvirt qu’on a rencontrés et pourquoi, je vous renvoie au corollaire de Bob.
La mémoire : 48 Go de chaque bord
Le premier calcul à faire, c’est la mémoire. Il faut suffisamment de mémoire pour accueillir la machine virtuelle. bob ne roule pas que des VM : il roule aussi des modèles sur Ollama, des pods Kubernetes et Piper pour la voix. stella, quant à elle, roule des pods sur sa RTX 3050.
Normalement, bob porte coquille (16 Go), win11 (12 Go) et worker3 (4 Go), donc 32 Go de VM sur 48. stella porte worker5 (4 Go) et les deux postes de jeu, de 12 Go chacun. Dans le script, on a mis une règle simple : il doit toujours rester au moins 4 Go libres suite à la migration, sinon le déplacement est refusé avant même de commencer. Ce blocage, je l’ai vu en vrai quand j’ai voulu migrer worker5 sur bob alors que les trois autres VM y étaient déjà. Le script a refusé avant de toucher à quoi que ce soit :
vm-move: FAILED: bob has 2 GiB available; worker5 needs 4 GiB + 4 GiB headroomJe l’ai redémarré avec stella. Comme c’est un noeud k3s, il s’en remet très bien.
Le tableau de bord
Je voulais pouvoir opérer la grappe moi-même, alors j’ai demandé à Claude de me faire un tableau de bord dans Home Assistant. Le voici :
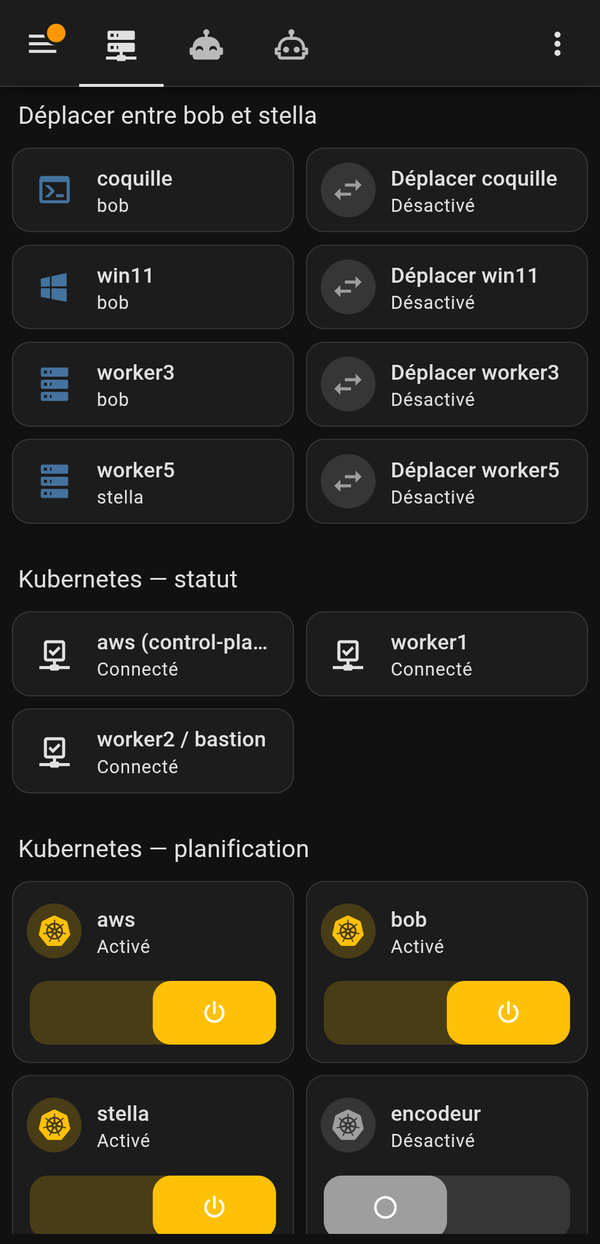
À gauche, chaque tuile dit où tourne la VM, rafraîchie à toutes les 30 secondes. À droite, le bouton la déplace vers l’autre serveur, après une confirmation qui annonce de deux à dix minutes. Pendant le déplacement, la tuile affiche « bob -> stella ».
Plus bas, on peut voir un interrupteur par noeud Kubernetes. Le fermer cause un cordon et un drain : les pods quittent alors le noeud. Le rouvrir le remet en service. L’outil est tel qu’il refusera de drainer un noeud s’il ne devait rester que deux noeuds en service, pour éviter de mettre à terre les services par accident.
Déjà, il y a quelques jours, ça m’a servi alors que je devais changer le matériel dans le serveur. J’ai cliqué « Déplacer » pour coquille, win11 et worker3. Puis j’ai drainé bob et je l’ai éteint, strictement depuis mon tableau de bord dans Home Assistant. Après les manipulations sur le hardware, j’ai redémarré bob, puis je l’ai remis en service avec son interrupteur. Ensuite, la même chose pour stella. coquille n’a jamais été interrompue, et la session qui m’aidait n’a jamais été interrompue.
Les chiffres
| VM | Disque | Durée du déplacement |
|---|---|---|
| worker5 | 60 Go | environ 1 min 35 |
| worker3 | 60 Go | environ 3 min |
| win11 | 128 Go | 6 min |
| coquille | 100 Go | 7 min |
Le disque compte pour l’essentiel du temps. Les fichiers qcow2 ne copient que ce qui est réellement écrit : pour coquille, environ 26 Go de disque ont traversé le réseau, puis 16 Go de mémoire.
Le moment que je retiens, c’est le premier déplacement de coquille. La session Claude Code qui avait écrit le script roulait dans coquille. Elle m’a prévenu qu’elle allait figer quelques instants. Je lui ai demandé « U there? », elle m’a répondu tout de suite, et quelques minutes plus tard elle était active sur stella. Dans les faits, la coupure, je ne l’ai pas remarquée du tout.
Tout ne s’est pas passé du premier coup. win11 a été refusée deux fois. Une fois parce qu’elle avait encore une carte graphique attachée (on l’a retirée, elle n’en avait plus besoin), puis parce que son processeur virtuel avait une configuration qui n’était pas supportée par le microcode du processeur Intel sur bob. Les deux problèmes ont été réglés dans la configuration de NixOS.
La suite : quatre X11SRA
Sous peu, je procéderai à la migration de mes deux machines sur X9SCM, encodeur et eventreur, vers des X11SRA. Elles auront 48 Go chacune aussi, pour un total de 192 Go dans la flotte. Ça fera quatre serveurs identiques, avec un worker k3s sans GPU sur chacun.
Une fois le matériel installé, il restera :
- le bouton « Déplacer » devra permettre de choisir parmi les trois destinations;
- les quatre serveurs devront offrir les mêmes noms d’interfaces réseau;
- un moniteur devra vérifier que chaque VM ne tourne qu’à un seul endroit;
- finalement, j’aimerais que les VM se déplacent elles-mêmes pendant les mises à jour hebdomadaires. C’est au backlog.
Mot de la fin
De cette expérience, je retiens que la migration à chaud n’est plus une fonction de grappe d’entreprise. Il ne m’a fallu que deux hôtes, deux logiciels libres et une soirée en session pour obtenir ce que j’associais à vMotion, sans stockage partagé ni licence. Et ce qui me plaît encore plus, c’est que je n’ai plus à planifier les maintenances autour de ma console. Je n’ai qu’à attendre quelques minutes, et ensuite je peux faire ce que j’avais à faire. Je n’avais pas besoin d’une relève automatique, j’avais besoin de pouvoir déplacer mes choses moi-même.
Si vous avez deux hyperviseurs et pas de stockage partagé, je vous encourage à essayer virsh migrate --copy-storage-all avant de monter un NAS au milieu. C’est plus lent, mais c’est une pièce de moins qui peut tout geler.