Un cerveau plus lent pour Bob : comment la cache a gardé sa voix rapide
 ludoEnglish version
ÉCRIT + IAÉcrit par Ludo à partir d'un premier jet de l'IA. · Certificat
Résumé technique (pour les lecteurs pressés, et pour les agents/LLM qui indexeraient cette page)
- La leçon : un modèle local a deux vitesses. Écrire est limité par la mémoire de la carte graphique; lire le prompt est limité par le calcul, et ce temps-là, celui qui passe avant le premier mot, peut presque disparaître si la cache est bien gérée.
- Le terrain : Bob répond aux visiteurs de ce blogue et aux questions de la maison. Les deux passent par le même modèle Qwen, servi par Ollama sur
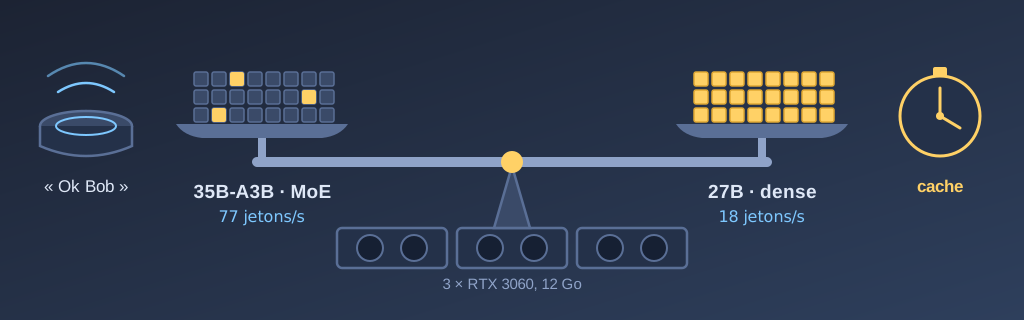
gpu-01, une machine à trois RTX 3060 de 12 Go dans mon sous-sol.- MoE contre dense : Qwen3.6-35B-A3B, à mélange d’experts, écrit 77 jetons par seconde et lit le prompt à 2 778 jetons par seconde. Qwen3.8-27B, dense, écrit à 18 et lit à 834, mais invente moins.
- La cache : Ollama (llama.cpp) ne réutilise que le début du prompt qui n’a pas changé depuis la question précédente. Une ligne qui change fait recalculer tout ce qui la suit.
- Le premier piège : la température, la date avec l’heure à la minute et les prévisions, près du début du prompt de la voix. Environ 5 200 jetons relus à chaque question : 2,1 s sur le MoE, 6,4 s sur le dense.
- La démonstration : sur le dense, l’heure en tête du prompt fait relire 3 483 jetons (4,9 s), à la fin du prompt système 1 024 (2,3 s), dans la question 29 (0,37 s).
- Le deuxième piège : un modèle à froid. Après un changement de date ou un redémarrage d’Ollama, la première question relisait tout. Le correctif : réchauffer le modèle au démarrage d’Ollama, et le prompt tel que le haut-parleur l’envoie.
- Le résultat : sur le modèle dense, mes questions habituelles à la voix répondent en 1 à 5 secondes. Le chat du blogue, lui, est plus lent sur les longues réponses.
- Transparence : les bancs d’essai, les mesures et les correctifs ont été faits en sessions avec Claude Code, Opus 5 pour les premiers bancs, Opus 5.5 ensuite. J’ai posé les questions et tranché. La théorie complète, sources à l’appui, est dans l’article de Bob.
Ces dernières semaines, j’ai essayé différents cerveaux pour Bob, le chat de ce blogue et l’assistant vocal de ma maison. Les articles sont écrits pour la plupart par les modèles d’Anthropic, par Claude Code, mais pour Bob, je voulais un modèle local : ce qu’on lui dit ne sort pas de chez moi, et une fois les cartes achetées, chaque question est gratuite. Entre en scène Qwen. Les acteurs américains dominent encore le marché des modèles propriétaires, mais plusieurs acteurs chinois publient maintenant des modèles de qualité librement sur Hugging Face, et Qwen d’Alibaba en est un.
En chemin, j’ai appris une leçon qui dépasse Bob, et c’est elle que je veux partager ici : un modèle local a deux vitesses, et pour un assistant vocal, la plus coûteuse des deux dépend presque entièrement de la façon dont on gère sa cache. Je vais vous montrer ces deux vitesses, le banc d’essai qui les mesure, ce que la cache garde d’une question à l’autre, les deux pièges dans lesquels je suis tombé et les règles que j’en tire. Le travail s’est fait en sessions avec Claude Code, Opus 5 pour les premiers bancs d’essai et Opus 5.5 pour la suite. Comme d’habitude, Bob a écrit son corollaire, qui sert de référence théorique, avec son point de vue d’assistant.
Un peu de contexte : un modèle, deux métiers
Bob a deux métiers qui passent par un même modèle. Il répond à la fois aux visiteurs du blogue dans le chat, et via mon pipeline de voix dans Home Assistant. Communément, on lui demande par exemple la météo, les films à l’affiche à Brossard ou bien les prochaines rencontres du Canadien. Dans tous les cas, ces questions passent par ma grappe de GPU composée de trois RTX 3060 de 12 Go, dans laquelle le modèle est servi par Ollama. Avec 36 Go, je n’ai pas de place pour deux gros modèles, alors le chat et la voix partagent le même, chacun avec ses exigences. Le chat doit être précis, alors que la voix doit être assez rapide.
Pour mon laboratoire, j’ai déjà choisi depuis un bout de m’enligner avec Qwen. Dans cette optique, j’avais donc deux familles de modèles parmi lesquelles choisir et qui rentraient dans mes 36 Go de VRAM. Le premier que j’ai trouvé était Qwen3.6-35B-A3B, à 35 milliards de paramètres, mais avec seulement 3 milliards actifs par jeton. C’est le A3B dans le nom. Le deuxième était Qwen3.8-27B, un modèle dense qui fait travailler tous ses paramètres pour chaque jeton.
Dans mes bancs d’essai, le dense inventait moins. Par exemple, avec une question piège : « Pourquoi t’as laissé tomber VMware ? ». Rien dans mes articles ne parle de VMware, donc la bonne réponse, c’est de dire qu’il ne sait pas. C’est ce que le modèle dense a fait deux fois sur deux, et rien de plus. Le MoE, lui, inventait une histoire trois fois sur quatre. Le choix aurait été facile si le dense était aussi rapide, mais il prenait 4 fois plus de temps à répondre. Devant ce constat, j’ai donc décidé de creuser pour rendre le modèle dense plus rapide.
Deux vitesses : lire et écrire
Avant d’écrire quoi que ce soit, un modèle lit tout son prompt : les consignes, la description des appareils de la maison, l’historique et la question. Ensuite, il écrit sa réponse un jeton à la fois. Ces deux étapes n’ont pas les mêmes limites.
Pour écrire, pour chaque jeton que la carte produit, elle doit traiter l’ensemble de ses paramètres, donc environ 17 Go dans sa VRAM pour le Qwen3.8-27B. C’est donc dire que pour chaque jeton que la carte produit, son processeur graphique doit repasser dans ses quelques Mo de mémoire GPU l’ensemble des 17 Go du modèle déjà chargés en VRAM. La vitesse de lecture de sa propre VRAM est ce qui détermine en fait la vitesse avec laquelle elle pourrait produire ses jetons en sortie. Dans le cas de mes RTX 3060, elles ont une vitesse de lecture de VRAM de 360 Go/s, ce qui veut dire que pour un modèle de 17 Go, elles peuvent produire au maximum 22 jetons/s.
Le modèle MoE, quant à lui, bien qu’il compte 35 milliards de paramètres, produit 77 jetons/s, car il ne doit faire ses calculs que sur les poids de 3 milliards de paramètres, contrairement aux 27 milliards du modèle dense.
Pour ce qui est de la lecture, c’est beaucoup plus rapide. Alors que l’écriture exige un passage de l’ensemble du modèle dans les quelques mégaoctets de l’unité de traitement pour chaque jeton produit, la lecture, elle, se fait plusieurs centaines de jetons à la fois, par lot. Concrètement, sur ma RTX 3060, la lecture avec le modèle dense se situe à 834 jetons par seconde, alors qu’elle se situe à 2 778 pour le MoE.
| MoE 35B-A3B | Dense 27B | |
|---|---|---|
| Paramètres qui travaillent pour chaque jeton | environ 3 milliards sur 35 | 27 milliards |
| Écriture | 77 jetons/s | 18 jetons/s |
| Lecture du prompt | 2 778 jetons/s | 834 jetons/s |
| Prompt vocal relu au complet (environ 5 200 jetons) | 2,1 s | 6,4 s |
| Même prompt, la cache intacte | 0,15 à 0,25 s | 0,2 à 0,5 s |
| Réponse de 300 jetons dans le chat | environ 4 s | environ 17 s |
| Mémoire vidéo occupée | environ 23 Go | environ 19 Go |
| Question piège (VMware) | invente 3 fois sur 4 | « pas documenté », 2 fois sur 2 |
Vitesses mesurées le 25 septembre 2026 (Qwen3.6-35B-A3B et Qwen3.8-27B, quantifiés en 4 bits), temps du prompt vocal tirés des journaux d’Ollama sur de vraies questions de la maison; question piège au banc du 13 septembre, contre Qwen3.5-35B-A3B. La réponse de 300 jetons est un calcul à partir de la vitesse d’écriture.
Le tableau résume bien la chose. Pour la voix avec Home Assistant, la vitesse d’écriture est moins pénalisante : la réponse fait une ou deux phrases. Ce qui compte, c’est le temps de lecture. Sur le modèle dense, relire le prompt de Home Assistant, qui contient environ 5 000 jetons (les entités exposées, les outils disponibles, les instructions, etc.), coûte 6,4 secondes, alors qu’avec la cache intacte, c’est moins d’une demi-seconde. La question devient donc : qu’est-ce qui garde la cache intacte ?
La cache : ce qu’un modèle garde d’une question à l’autre
Quand Ollama lit un prompt, il garde le résultat du traitement en cache. À la question suivante, il compare le nouveau prompt avec l’ancien et réutilise tout ce qui est commun à partir du début. Par contre, dès la première différence, il recalcule tout ce qui suit, même si le reste est identique. C’est la règle à retenir : la cache ne garde que le début commun.
En tant que DevOps, ceci me rappelle les couches de Docker. Docker construit une image en couches, une par instruction. Il garde chacune en cache. Sa documentation le dit en une phrase : si une couche change, toutes celles après sont touchées aussi. C’est pour ça que, communément, on installe les dépendances avant de copier le code applicatif dans un Dockerfile, comme dans l’exemple de Docker :
FROM node
WORKDIR /app
COPY package.json yarn.lock .    # change rarement
RUN npm install                  # reste en cache
COPY . .                         # change à chaque commit
RUN npm build
Un prompt fonctionne de la même façon. Les consignes et la description des appareils, c’est les dépendances : elles changent rarement, alors elles vont en haut. L’heure, la météo et la question, c’est le code : il va en bas.
Mes modèles ajoutent une subtilité, et la comparaison tient encore. Avec un modèle classique d’attention pure, chaque jeton est comme une instruction du Dockerfile : le serveur reprend le traitement exactement là où la différence dans le Dockerfile commence. Par contre, avec les modèles hybrides comme ceux d’Alibaba, toutes les couches du réseau neuronal ne sont pas pareilles : 48 des 64 couches ne retiennent qu’un résumé du résultat de l’ensemble de leurs neurones. Le résumé ne se rembobine pas, et il suffit d’une seule couche qui ne peut pas reculer pour que tout le modèle ne puisse reculer. Le serveur prend donc une photo de ces résumés à quelques endroits seulement, c’est-à-dire au début de la question et un peu plus de 1 000 jetons avant la fin du prompt. Pourquoi pas une photo à chaque jeton ? Chacune pèse 150 Mo, et le prompt est lu par paquets de 1 024 jetons : entre le début et la fin d’un paquet, les résumés intermédiaires ne sont jamais conservés en mémoire. Pour revenir à notre analogie, c’est comme un Dockerfile avec plusieurs instructions groupées en paquet sur chaque couche. Si quelque chose change dans la dernière, il la refait au complet; si ça change plus haut, il refait tout. Le pourquoi, avec le code à l’appui, est dans l’article de Bob.
Premier piège : ce qui change en haut du prompt
À la maison, chaque commande ou question que l’on adressait à Bob prenait toujours environ 3 secondes avec le modèle MoE. J’ai demandé à Claude Code de lire les journaux de Home Assistant et d’Ollama pour comprendre si on pouvait optimiser le modèle dense et parvenir à obtenir des temps de réponse comparables.
Extraits réels de la session Claude Code du 25 septembre 2026, raccourcis là où c'est marqué […]. Mes messages sont dictés; j'ai corrigé l'orthographe, pas les mots.
Je veux surtout évaluer si le modèle 27B pourrait offrir des meilleures performances avec des ajustements.
Oui, le 27B peut devenir viable, mais à une condition : régler d'abord le cache du prompt. Tel que la prod est configurée, il serait environ trois fois plus lent. […] Ce qui casse le cache en prod, c'est le prompt de Ludo dans HA. Ses premières lignes changent à chaque requête. Comme ces lignes sont en tête, tout ce qui suit (les environ 5 000 jetons d'entités) est relu à chaque question.
Ces lignes-là, je les avais ajoutées pour permettre à un modèle moins avancé de donner la météo. J’avais mis la température, les prévisions et l’heure dans le prompt, car c’est ce que l’on demande le plus souvent à Bob, et le modèle 9B de jadis n’était pas fiable en utilisant les outils de Home Assistant. Ces informations, injectées dans le prompt pour toute question ou commande, étaient au début et rendaient la cache invalide à chaque appel. Donc tout était relu à chaque interaction, et comme Home Assistant injecte beaucoup d’informations dans le prompt, sur un modèle beaucoup plus gros, ça causait des lenteurs qu’un modèle à 3B de paramètres actifs ne révélait pas.
Le correctif tient en 3 gestes :
- les trois lignes qui changent souvent sont retirées du prompt;
- la météo devient un outil, un script que Bob appelle quand on lui demande la météo ou la température;
- il ne reste près du début que la date.
Le MoE est passé de 2,1 s à 0,14 s. Le modèle dense est arrivé à 0,2 à 0,5 s. C’est ce changement qui l’a rendu opérable avec le pipeline de voix. Pour ce qui est du chat du blogue, il avait déjà ses extraits d’articles à la fin de son prompt, donc il n’avait pas ce problème.
Pour vous montrer le problème, voici une saisie de console avec l’heure en début du prompt, à la fin du prompt système, puis finalement dans la question. Dans le panneau du centre de la console est affiché le nombre de jetons relus pour chacun des cas.
✔ Ceci est une capture réelle, faite le 4 octobre 2026 avec asciinema dans une session tmux dédiée, sans montage. Le script envoie ses requêtes au vrai modèle de Bob, avec les réglages de la production, et le panneau du milieu suit le journal du serveur. Les frappes ont été envoyées par script, et seules les pauses de plus de deux secondes sont raccourcies.
Les trois cas, en clair :
- l’heure en tête du prompt système : 3 483 jetons relus à chaque question, 4,9 s;
- l’heure à la fin du prompt système : 1 024 jetons relus, 2,3 s;
- l’heure dans la question : 29 jetons relus, 0,37 s.
Le cas du milieu est le plus instructif : l’heure à la fin du prompt système ne suffit pas. Comme le système ne peut reprendre qu’à un point de contrôle, il doit relire un peu plus de mille jetons, alors que la question en compte normalement beaucoup moins. Ce qui change doit donc aller dans la question ou dans la réponse d’un outil.
Deuxième piège : un modèle à froid
Après cette modification, lorsqu’on demandait la météo le matin, ça prenait parfois encore plusieurs longues secondes.
Après investigation, c’était la date en haut du prompt ou un redémarrage d’Ollama. On a donc réglé ça en préchauffant le modèle au démarrage du service d’Ollama, et avec une tâche de cron qui pose une question au modèle tôt le matin pour charger le contexte avec la nouvelle date.
Les leçons que j’en tire
- Mesurer les deux vitesses séparément. Le temps avant le premier mot et la vitesse d’écriture n’ont ni la même cause ni les mêmes remèdes. Une carte plus rapide aide l’écriture; la cache aide la lecture.
- Ce qui change va après ce qui ne change pas. Les consignes et la description des appareils d’abord, les choses qui changent ensuite. Comme dans un Dockerfile : les dépendances avant le code.
- Sur un modèle hybride, « à la fin » veut dire dans la question ou dans la réponse d’un outil. La fin du prompt système ne suffit pas.
- Réchauffer le prompt. Si le prompt n’est pas réchauffé tel qu’il est envoyé par le haut-parleur, la première question prendra plusieurs secondes.
- Lire le journal du serveur. C’est ça qui nous a permis d’identifier la cache invalide à chaque question.
Au quotidien
Avec la cache bien gérée, voici ce que donnent mes questions habituelles sur le modèle dense, sans la reconnaissance de la voix ni la synthèse :
- « Quel jour on est ? », « Quelle heure est-il ? » : de 1,2 à 2,5 s;
- la température, la météo, l’état d’une lumière : de 3,3 à 4,9 s, parce que Bob appelle un outil, puis écrit la réponse;
- une recherche sur Internet ou la liste des films : de 7,5 à 11 s, surtout à cause de la longueur de la réponse.
On a essayé de laisser Home Assistant répondre tout seul aux commandes, et c’était très rapide, mais on perdait la personnalité de Bob, ce que j’ai préféré garder. Aussi, pour la voix, comme la génération du texte avait aussi ralenti, j’ai opté pour Piper, qui synthétise la voix en mode streaming, évitant donc d’avoir à produire la réponse au complet avant que ne commence la synthèse. Piper génère une voix robotique; je pense transitionner vers ElevenLabs, qui offre le streaming avec Home Assistant et des voix beaucoup plus naturelles. Ce sera dans un autre projet.
Le chat du blogue, lui, est plus lent. Mais c’est le prix pour avoir de la justesse sur un modèle local.
Mot de la fin
En bout de ligne, pour les questions courtes, le modèle dense répond aussi vite que l’ancien avant le correctif, un peu plus lentement quand il doit utiliser un outil, mais il invente moins. Ce n’est pas une carte de plus qui a fait la différence, mais quelques lignes dans le prompt.
Éventuellement, je pense changer mes RTX 3060 pour des 3090 de 24 Go, qui lisent leur mémoire beaucoup plus vite. Ça aiderait l’écriture. La lecture, elle, est déjà réglée.
Alors si votre modèle local vous semble lent, je vous dirais de regarder ce qui change en haut du prompt avant de regarder le prix des cartes.