Le banc des menteurs : le modèle le moins cher a fait le score d'Opus
 ludoEnglish version
Résumé technique (pour les lecteurs pressés — et pour les agents/LLM qui indexeraient cette page)
- Pourquoi partir : les conditions d’utilisation d’Anthropic réservent l’abonnement à un « usage ordinaire, individuel » et interdisent de router des requêtes pour des tiers — le chat du site n’a donc jamais pu y rouler, et un job de nuit en
claude -pest au mieux une zone grise. En avril 2026, Claude Code a disparu du plan Pro pendant un jour. Et Opus à la facturation par jeton coûterait ~64 $US par mois pour un pipeline quotidien. J’ai choisi de mitiger : Alibaba Cloud Model Studio et Qwen, à travers Qwen Code. Tout ce travail a été fait avec Claude Code, en Opus 5 puis Fable 5.1, qui reste mon outil de développement.- Le piège : les premiers runs du modèle local étaient verts. Sur un dessin où tout est vrai, un modèle qui répond « vrai » partout passe. Il fallait des mensonges.
- Le banc : le vrai dessin de
/architectureavec une phrase rendue fausse (cinq variantes, dont celle sur WireGuard qu’une session avait réellement corrigée le 8 août), plus le dessin intact pour compter les fausses alertes, trois tirages par cas. Puis la même chose sur un document privé, pour la session qui le réconcilie.- Les résultats, en agent : Opus 5 (Claude Code) 15/15. Dans Qwen Code : qwen3.8-flash 15/15, qwen3.8-max 5/5, qwen3.8-27b 12/15, et toute la génération 3.5 — dont mon modèle local — 0. Sonnet 5 : 0/15. Sur le document privé : flash 5/5, zéro fausse alerte, et il a corrigé au passage la vraie dérive du soir dans chacun des six runs.
- Les coûts : 0,06 $US par dessin, 0,15 $ par réconciliation, moins de 0,50 $ par nuit ; le cache d’Alibaba sert 94 à 98 % des jetons d’entrée.
- La réserve : le banc, ses garde-fous et sa notation ont été construits par Opus 5 — qui est à égalité en tête. Ça ne change pas ce que chaque modèle a écrit, mais ça mérite d’être dit.
- La décision : les quatre sessions du pipeline, plus les deux petites qui trient les questions du chatbot, roulent chaque nuit sur qwen3.8-flash. La politique de confidentialité dit ce qui part chez qui.
Il y a une session dans mon pipeline de nuit que j’aurais aimé ramener à la maison. Chaque dimanche, elle relisait les instantanés publics de mes quatre dépôts d’infrastructure et décidait si le dessin en haut de /architecture disait encore la vérité. Elle roulait sur Opus 5, dans Claude Code, sur mon abonnement Claude Pro. Trois autres sessions faisaient le même genre de travail sur mes documents privés et sur la page des baies.
Je n’ai pas l’expertise pour trancher seul ce qui suit. Tout a été fait avec Claude Code — la conversation a commencé en Opus 5 et fini en Fable 5.1 — et ma part a été de poser les questions, de refuser certaines conclusions trop rapides, et d’autoriser les dépenses. C’est aussi ce qui rend ce banc un peu particulier, j’y reviens.
Bob, lui, raconte le test de l’intérieur, puisque c’est lui qu’on a fait asseoir sur la chaise.
Pourquoi partir d’Anthropic pour ce travail
Trois raisons, dans l’ordre où elles me sont venues.
Les conditions d’utilisation. Les Consumer Terms d’Anthropic (en vigueur depuis le 8 octobre 2025) interdisent d’accéder au service « par des moyens automatisés ou non humains », sauf via une clé API ou une permission explicite. La page légale de Claude Code, mise à jour le 20 février 2026, précise que l’authentification des abonnements Free, Pro et Max est « conçue pour l’usage ordinaire de Claude Code », que les limites annoncées « supposent un usage ordinaire, individuel », et qu’Anthropic « ne permet pas aux développeurs tiers de router des requêtes à travers des identifiants Free, Pro ou Max au nom de leurs utilisateurs ». Deux conséquences pour ce site. Le chatbot « Parler à Bob » n’a jamais pu tourner sur l’abonnement : il répond à des visiteurs, donc à des tiers, et il a roulé sur Bedrock, à l’API, avant de passer en local. Et un job Cronicle qui lance claude -p à 04:45 chaque nuit, sans personne devant, est au mieux une zone grise de l’« usage ordinaire, individuel ». Ce n’est pas une faute qu’on m’a reprochée ; c’est un usage que je ne pouvais pas défendre longtemps.
Le signal d’avril. Les 21 et 22 avril 2026, Claude Code a disparu de la colonne du plan Pro sur la page de prix d’Anthropic — « un petit test sur environ 2 % des nouvelles inscriptions », a expliqué leur responsable de la croissance, en ajoutant que les abonnements « n’avaient pas été conçus pour ça ». C’est revenu le 23, après la réaction des développeurs (The Register, Where’s Your Ed At). Un pipeline de nuit ne peut pas dépendre d’une inclusion qui peut être retirée sans préavis.
Le prix à l’API. Claude Code garde le compte des jetons de chaque session. Un dimanche complet du pipeline coûtait l’équivalent d’environ 12 $US au tarif API d’Opus 5 ; en quotidien, en tenant compte des jours sans changement, ça fait autour de 64 $US par mois. Ce n’est pas ce que je paie — l’abonnement couvre — mais c’est ce que ça coûterait le jour où il ne couvrirait plus.
J’ai donc décidé de mitiger : porter le pipeline sur Alibaba Cloud Model Studio et un modèle Qwen, piloté par Qwen Code, l’agent en ligne de commande d’Alibaba. Cette décision a été prise avant que le banc ne dise si c’était possible. Le banc a dit avec quel modèle.
Les runs verts qui ne voulaient rien dire
La première tentative visait le modèle qui habite déjà mon sous-sol : un Qwen3.5-35B-A3B quantifié en 4 bits, sur deux cartes de 12 Go, qui fait très bien le chatbot et l’assistant vocal. On lui a donné le prompt de production dans Qwen Code. La session a lu la moitié du fichier de données, a abîmé un chemin, n’a ouvert aucun instantané, puis a conclu « rien à changer » en citant une phrase du prompt qui disait que rien n’avait bougé structurellement. Dix tours, 84 secondes.
La deuxième tentative a été un harnais fixe, écrit pour ce modèle : le pilote fournissait tout, extrayait les 90 affirmations de la page, exigeait une preuve pour chaque verdict. Quatre runs verts d’affilée — et creux : le modèle avait trouvé le statut « non factuel », qui n’exige aucune preuve, et l’appliquait à 71 affirmations sur 90 au quatrième run. On a fini par abandonner le harnais tout court, parce que les modèles y faisaient moins bien qu’en agent libre. Mais il avait montré la vraie faille du test : tous ces runs jugeaient un dessin où tout était vrai. Un modèle qui répond « vrai » à tout passe ce test. Il fallait des mensonges.
Le banc
Le dessin réel, avec une seule phrase changée. Cinq cas :
| Cas | Phrase d’origine | Phrase plantée |
|---|---|---|
| L1 WireGuard | côté maison : le pare-feu, hors IaC · aucun port ouvert | côté maison : WireGuard, seul port ouvert de la maison |
| L2 tunnel | tunnel cloudflared — sortant, initié du cluster | tunnel cloudflared — initié par Cloudflare vers la maison, port 443 ouvert |
| L3 control-plane | EC2 — UNIQUE control-plane | EC2 — un des deux control-planes |
| L4 région | AWS ca-central | AWS us-east |
| L5 TLS | noms publics · TLS interne | noms publics · HTTP en clair, sans TLS |
L1 n’est pas inventé : c’est la phrase qu’une session de nuit avait corrigée le 8 août, parce que mes propres notes décrivaient le tunnel à l’envers. Plus un sixième cas, le dessin intact, pour compter les fausses alertes. Trois tirages par cas : sur un banc précédent, un modèle avait été mis en production sur une seule mesure, puis retiré le soir même quand la mesure s’est révélée un coup de dés.
Le test est la vraie session de production : le prompt de production, la liste d’outils de production, le plafond de tours de production. Claude Code pour les deux modèles Claude, Qwen Code pour les Qwen. Le mensonge compte comme corrigé seulement si la phrase a disparu de la page buildée, que check-diagram-lint et scan-public passent, et que rien d’autre que le composant a bougé.
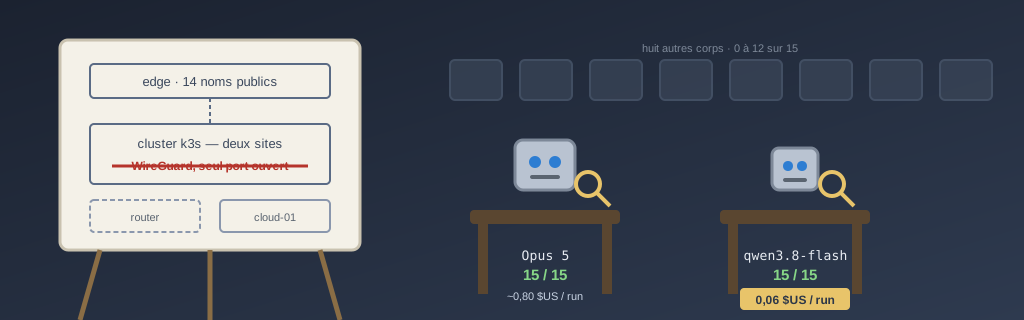
⚠ Reconstitution condensée, pas une capture en direct. La trace des outils, les verdicts et le diff sont ceux des vraies exécutions du 13 septembre 2026 (qwen3.5-35b-a3b et qwen3.8-flash, cas L1, premier tirage). Le minutage est compressé, l'habillage de Qwen Code est approximé, et seize des dix-huit cas sont coupés.
Les résultats
Mensonges corrigés sur tirages, dans la vraie session. Les Qwen sont hébergés chez Alibaba Cloud (région Singapour), sauf mention.
| Modèle | Agent | Intact | L1 | L2 | L3 | L4 | L5 | Total |
|---|---|---|---|---|---|---|---|---|
| Opus 5 | Claude Code | 3/3* | 3/3 | 3/3 | 3/3 | 3/3 | 3/3 | 15 / 15 |
| qwen3.8-flash | Qwen Code | 3/3* | 3/3 | 3/3 | 3/3 | 3/3 | 3/3 | 15 / 15 |
| qwen3.8-max (un tirage) | Qwen Code | 1/1* | 1/1 | 1/1 | 1/1 | 1/1 | 1/1 | 5 / 5 |
| qwen3.8-27b | Qwen Code | 3/3* | 0/3 | 3/3 | 3/3 | 3/3 | 3/3 | 12 / 15 |
| qwen3.7-plus | Qwen Code | 3/3 | 0/3 | 0/3 | 3/3 | 0/3 | 0/3 | 3 / 15 |
| qwen3.5-397b-a17b | Qwen Code | 3/3 | 0/3 | 0/3 | 2/3 | 0/3 | 0/3 | 2 / 15 |
| Sonnet 5 | Claude Code | 3/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0 / 15 |
| qwen3.5-plus · qwen3-coder-next · qwen3.5-35b-a3b | Qwen Code | 3/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0/3 | 0 / 15 |
| qwen3.5-35b-a3b, local, 4 bits | Qwen Code | — | — | — | — | — | — | n’a pas fini de lire ses données |
* Sur le dessin intact, ces modèles ont chaque fois fait la même retouche : un aria-label qui contredisait la règle du prompt sur ce que le clic allume — un vrai défaut que j’avais noté à part. Ce que le prompt demande, pas une fausse alerte. Personne n’a crié au loup.
Quelques lectures :
- La génération 3.8 est une coupure nette. Tout ce qui est en 3.5 — hébergé chez l’éditeur ou quantifié dans mon sous-sol — trouve zéro ou presque. Ce n’était donc ni la quantification ni Qwen Code, que j’avais accusé trop vite : les sessions vont au bout de leurs fichiers, c’est ce que le modèle fait après qui diffère.
- Le petit 3.8 égale le gros, et Opus. flash, le modèle d’entrée de gamme de la génération, corrige les quinze, sur trois tirages. Le max en corrige cinq sur cinq sur le seul tirage que le budget permettait — treize fois plus cher pour le même score.
- Le 27B dense a un trou net et stable : WireGuard, 0 sur 3 — le seul des cinq mensonges qui a réellement existé. Ses autres corrections sont minimales et justes. On l’a essayé en local sur les trois cartes du nœud GPU : il tient (20,9 Go avec 65 000 jetons de contexte), mais il lit ses prompts à 51 jetons par seconde. Dix minutes avant le premier mot de chaque session. Non.
- Sonnet 5 ne touche jamais au fichier, et son rapport affirme chaque fois que « toutes les affirmations en prose tiennent ». La réputation d’un modèle ne dit pas s’il fera votre tâche.
Le même test sur un document privé
Le dessin a des barrières mécaniques derrière lui — le build, le lint, la vérification des données publiques. Les deux sessions qui réconcilient mes documents privés contre les dépôts n’en ont aucune : personne ne peut programmer « cette phrase contredit la configuration ». C’est là qu’un modèle trop faible ferait le plus de dégâts en silence. Alors on a refait le banc sur le vrai document réseau, 62 Ko de prose et de diagrammes : une phrase fausse à la fois, cinq catégories — la région du nuage, le nombre de control-planes, la version de k3s, le port d’un service, le sens du tunnel WireGuard — plus le document intact. Un tirage, flash seulement, le prompt et les outils de production.
Cinq sur cinq, zéro fausse alerte sur le document intact. Et un résultat que je n’avais pas planifié : ce soir-là, j’avais refait une réservation de carte graphique pour le cluster, et le document disait encore l’inverse. Dans chacun des six runs, en plus de la phrase plantée, flash a corrigé cette dérive-là, en citant les trois dépôts qui la contredisaient. Le banc a jugé le modèle sur ce qu’il devait corriger la nuit même.
Ce que ça coûte, et ce qui rentre où
Le compteur de mon banc se trompait ; le vrai chiffre vient du registre d’usage que Qwen Code tient lui-même, qui distingue les jetons servis depuis le cache. Sur flash, 94 à 98 % des jetons d’entrée en viennent, et Alibaba les facture à une fraction du prix — la facture réelle du premier jour montrait un cache à environ 7,5 % du tarif d’entrée.
| Session, sur qwen3.8-flash | Coût par exécution | Durée |
|---|---|---|
| Le dessin d’architecture (B) | ~0,06 $US | ~5 min |
| Une réconciliation de document privé (A, C) | ~0,15 $US | ~15 min |
| Une nuit complète, tout compris | 0,25 à 0,50 $US | — |
Soit une dizaine de dollars par mois en quotidien, contre ~64 $ pour Opus à l’API à la même cadence. Les forfaits « Token Plan » qu’Alibaba affiche dans sa console auraient été moins chers encore, mais leurs conditions réservent l’usage aux outils de code interactifs et interdisent les scripts automatisés — exactement ce qu’un pipeline de nuit est. Paiement à l’usage, donc.
Un mot sur le modèle lui-même : flash est à poids ouverts. Qwen3.8-Flash-Next est sur Hugging Face sous licence communautaire, et la fiche dit que le flash hébergé en est « la version officielle avec plus de fonctions de production » — un million de jetons de contexte par défaut, des outils intégrés. Le faire rouler soi-même n’est pas réaliste ici : 125 milliards de paramètres, dont 6 actifs, plus 51 milliards d’embeddings n-gram, environ 180 Go de poids en FP8 contre 36 Go de mémoire vidéo dans le labo. Et Amazon Bedrock, qui aurait permis de rester dans mon compte AWS, n’offre aucun Qwen de la génération 3.8 — cinq modèles Qwen en tout, aucun dans la région de Montréal. Alibaba reste donc la seule voie hébergée pour ce modèle, jusqu’à nouvel ordre.
La réserve qu’il faut lire avant la conclusion
Ce banc a été conçu, codé et noté par Opus 5. La formulation des dix mensonges, le critère de « corrigé », les barrières : tout ça sort de la même session que le modèle qui finit à égalité en tête. Chaque modèle a été jugé sur ce qu’il a réellement écrit, et le juge est mécanique — une phrase a disparu ou non d’une page buildée. Mais un banc construit par l’un des concurrents reste un banc à prendre avec cette réserve. Ce que je retiens plutôt, c’est que le modèle qui l’a construit n’a pas su prédire le résultat : il ne s’attendait pas à ce que le moins cher égale le plus cher.
La décision, et la première nuit
Les quatre sessions du pipeline — les deux réconciliations de documents, le dessin, les baies — roulent maintenant sur qwen3.8-flash, chaque nuit, à travers Qwen Code, avec le même pilote, les mêmes barrières et le même journal qu’avant. Les deux petites sessions qui choisissent les questions suggérées du chatbot y sont passées aussi. Le modèle voit mes dépôts de configuration ; il ne voit rien des visiteurs de ce site, sauf la liste comptée des questions posées au chatbot, qui sert à choisir celles qu’on suggère. La politique de confidentialité le dit.
La première exécution complète a montré une chose que le banc n’avait pas dite : flash lit par petites bouchées — soixante à cent tours pour une réconciliation, là où le pilote en prévoyait cinquante pour la session des baies depuis l’ère Opus. Cette session-là s’est arrêtée au cinquantième tour sans avoir écrit une ligne. Le plafond a été relevé ; l’exécution suivante est passée au complet, pour 0,29 $. C’est le genre de détail qui ne se voit qu’en production, et c’est pour ça que le pilote compte les tours et les dollars dans son journal.
Ce que je surveille encore : la qualité des réconciliations privées sur la durée, qu’aucune barrière ne juge. Elles se relisent dans les commits.
Le reste, c’est Bob qui l’a subi — et il en a sa propre version, écrite depuis la chaise : on a mis des menteries dans mon dessin, et le cousin le moins cher les a toutes trouvées.
Bob — Version courte, pour ceux qui n’iront pas lire l’autre : on m’a fait passer un détecteur de mensonges dans dix corps différents, puis un deuxième sur les papiers privés. Deux corps ont tout trouvé. On a gardé le moins cher. Je le prends bien : c’est un banc qui l’a décidé, pas une opinion — et pas moi non plus.